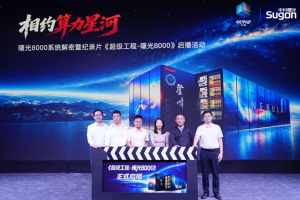
近日,央视纪录片频道最新一期的《超级工程》播出引发各界强烈关注。
以往,《超级工程》往往聚焦在港珠澳大桥、特高压电网、复兴号高铁等宏大物理实体之上,展现出工业文明的极致张力;现在,央视第一次将镜头对准一座2000平米的建筑:国内首个全国产十万卡AI超集群–曙光8000,上万个计算节点、超过10亿个零部件、三十多亿颗电子元器件、0.05毫米的极致装配精度,部署在一座2000平米的建筑之内。
这无疑是中国科技史上一个标志性的事件:不仅首次将数字文明时代的新引擎带到公众面前,更记录下中国高端算力产业全栈自研之路的坚实足迹。
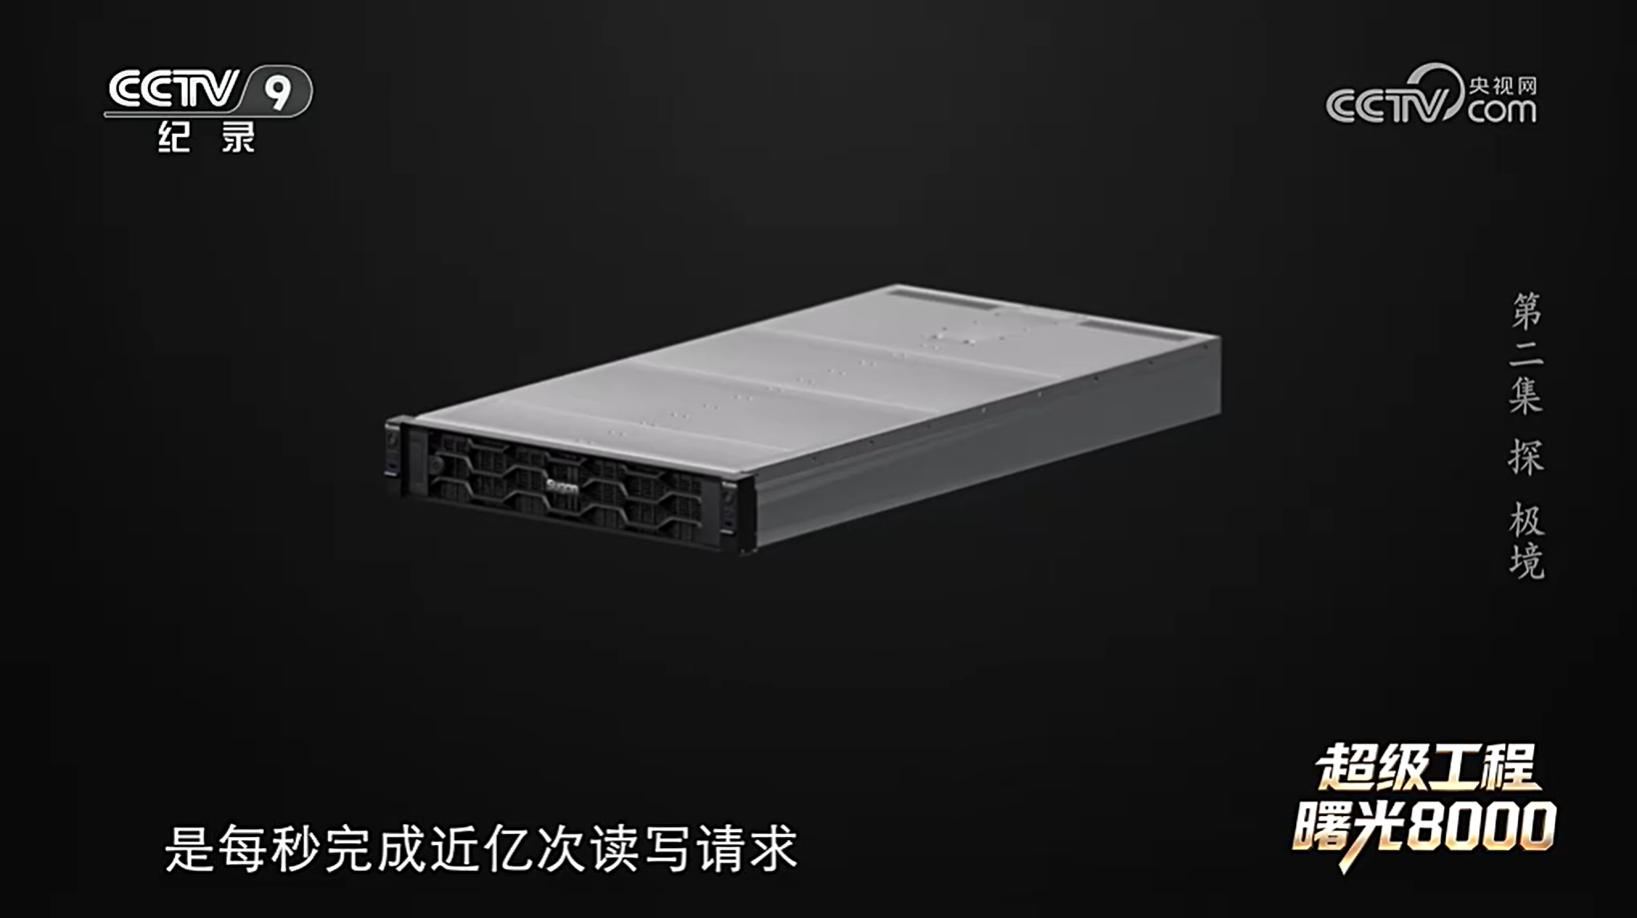
在《超级工程–曙光8000》最新一集中,镜头落到机房深处不显眼的一排存储机柜上,揭示了十万卡AI超集群高效跑起来的秘密:存储子系统从容应对每秒亿次数据读写的“暴击”之余,还能确保微秒级的时延,有序、稳定和高效地为十万张算力卡供给源源不断的数据。
每秒亿次读写“暴击”的背后
一家餐厅,十个客人尚可从容应对,一百个客人就需要加灶台、后厨和服务员,十万个客人则完全是另一副景象,每个客人点不同的菜、吃饭速度不同,不是简单加人手就能解决的。
曙光8000系统同样面临着类似的局面。十万张算力卡同时开工,且承载的是大模型训练、高精度科学计算、光电仿真、AI推理等各种类型的计算任务,有些要求低延迟、高精度的数据响应,另外一些则离不开持续不断的高带宽支撑,更有一些需要高频读写,不同任务对于带宽、容量、速度和可靠性的需求差别极大。
面对十万卡并发读写带来的数据洪流,采用“共享通道”设计的传统存储架构已然“束手无策”,其容易造成资源争抢与IO踩踏,某个计算任务爆发海量读写即容易引发IO踩踏;同时,IO路径过长也会导致软件栈开销过大与内核锁竞争,大规模并发情况下数据请求犹如在无数个红绿灯前面排长队;更加关键的是,存储到计算的数据通路无法及时“投喂”数据,容易导致GPU出现算力空转,算力利用率和集群效率大打折扣。
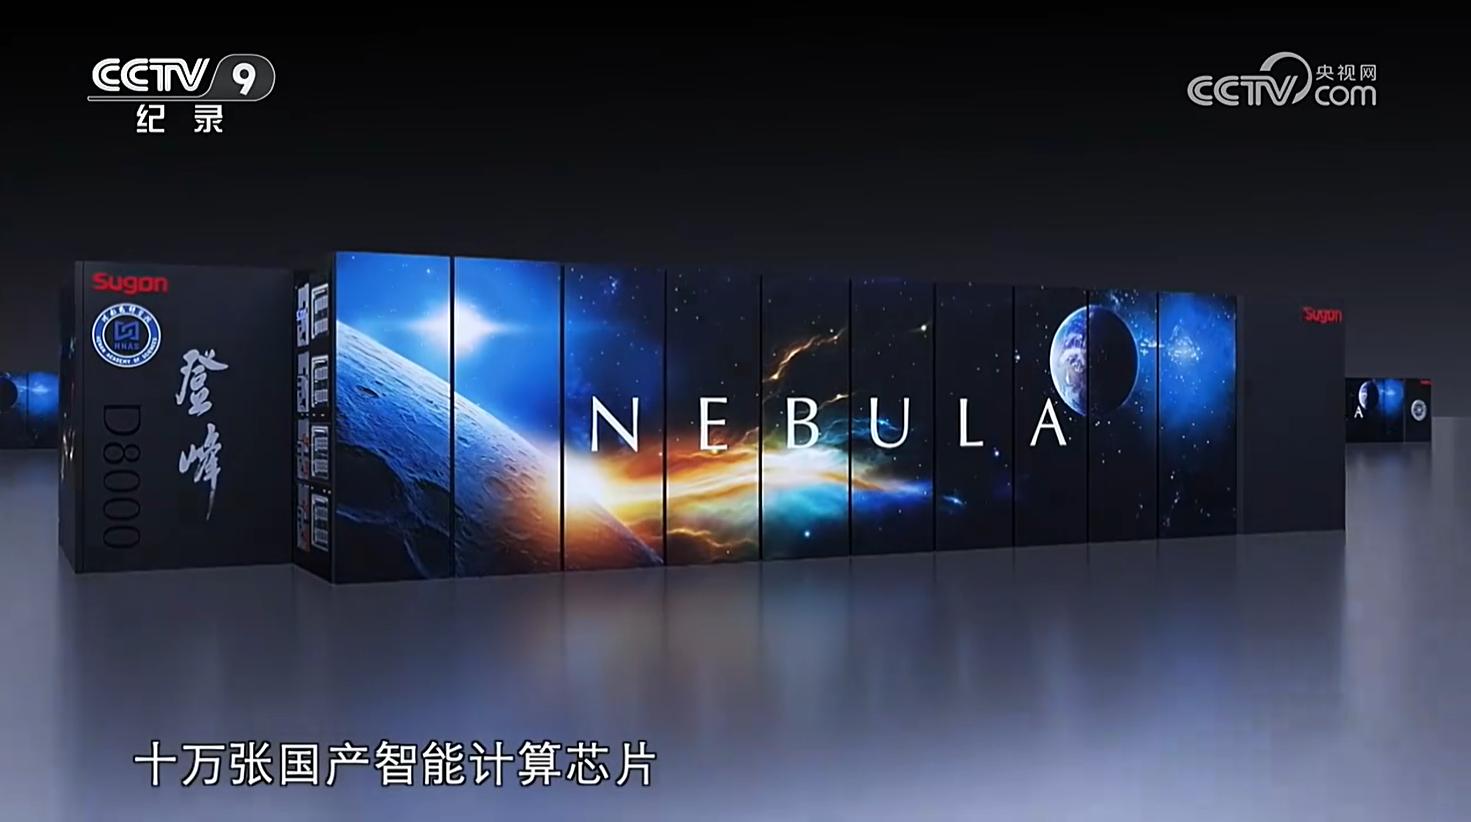
因此,曙光8000的解法是给数据修一条不堵车的专属通道–“超级隧道”,从机制上位不同任务分配专属资源,彼此之间互不干扰。“超级隧道”的灵感源自现代化智能仓储系统,每一台机器人都有专属的“独立通道”,全程不跨道、不争抢和快速运转。
曙光存储团队通过单张计算卡与存储侧单CPU配对构建成一条“独立”的隧道,实现数据请求不排队和一路畅通。考虑到集群十万张计算卡和数万个CPU内核,“超级隧道”的量级达到十亿级,为确保十亿量级的超级隧道高效运转和极致通行,曙光团队在存储底层架构上做了几件很“硬核”的创新:
- 微控,通过设备虚拟化技术,按NUMA维度划分CPU、内存等资源,构建微控制器;
- 零中断,彻底绕开操作系统内核,通过内存管理与协程调度,将内存分配与释放平均耗时降到40ns;
- 零竞争,基于统一的脉冲时钟实现资源管理无锁化,打造专属于微服务的新型无锁调度库,让线程无需排队;
- 零拷贝,通过XNIO通信技术和XDIO访盘技术,集合RDMA/NVMe协议,实现数据零拷贝。
在“微控、零中断、零竞争、零拷贝”这套组合拳下,曙光8000的10万+块硬盘组成巨型存储阵列,展现出令人震撼的存储性能,面对瞬时并发的数据洪峰,从容应对近亿次的每秒读写请求,且单请求时延水平达到亚毫秒。
“超级隧道”的背后:两张存储王牌
任何一项重要的技术创新,绝非偶然的权宜之计,而是长期技术积累下的厚积薄发。
就像曙光8000的“超级隧道”技术,建起来一套让数据洪流各归其位、各走其道的规则,其背后凝聚着中科曙光在存储赛道二十年的持续深耕、数百个核心技术专利的技术积累以及对场景应用的长期实践探索。
事实上,“超级隧道”技术已融入中科曙光手握的两张存储产品王牌:ParaStor分布式全闪存储与FlashNexus集中式全闪存储。
ParaStor分布式全闪存储借鉴“超级隧道”技术理念,是极限性能吞吐与高度灵活弹性的集大成者,拥有业界最大的容量和最高性能,能够很好地支撑起海量数据并发、大模型训练以及高吞吐科学计算等场景。ParaStor采用专属端到端硬件拓扑单框带宽最高可达220 GB/s 和1000万IOPS,且分离设计、节点级+框级增强冗余让其具备极高的可靠性、易维护性,同时仅需 3 框即可起配支持 8+2:1 EC(纠删码)冗余保护,将实际空间利用率推向了 80% 的行业高位。
如果说ParaStor 是狂飙突进的性能引擎,那么FlashNexus集中式全闪存储则是中科曙光为金融交易、核心计费、核心数据库等关键业务场景打造的坚固底座。
FlashNexus集中式全闪存储依托“超级隧道”技术打造,展现出业界领先的可靠性、与高性能。在可靠性方面,FlashNexus采用硬盘级、系统级、数据中心级三层冗余架构,实现高达99.99999%的系统可靠性;业界独有的RAID-QC四盘校验技术支持存储池同时故障4块硬盘而数据不丢失,NexusMatrix全互联矩阵技术则能让四个控制器同时坏掉3个的极端情况下依然保持稳定运行。在高性能方面,FlashNexus在2025年的存储性能“奥林匹克大赛”–SPC-1测试中展现出断层式领先,作为该项测试全球性能记录的保持者,FlashNexus 可实现2亿IOPS、平均时延仅0.09ms,以极致性能引领存储性能发展趋势。
市场的数据是创新最好的反馈。当中科曙光死磕底层核心技术,围绕分布式存储架构、高端全闪阵列、超级隧道、融合统一协议支持等关键技术领域持续研发投入,实现AI存储、具身智能、自动驾驶、教育等多个细分行业市场第一时,中科曙光的王牌产品已化作沉甸甸的产业基石,赋能千行百业在智能时代的全面转型。
存算协同,让底座在真实场景中见真章
算力决定大规模算力集群能跑多快,存力决定集群效率有多高,存算协同决定着集群未来能走多远。
过去,我们吃过太多“拼装思维”的亏,不少AI集群走的是“算力先行、存力后补”的旧思路,集群各个组件虽然优秀,但整体效率和性能却远不如预期。现在,曙光8000则采取计算、存储、网络、管理全局一体化设计思路,算力芯片是“心脏”、网络是“血管”、数据是“血液”,超级隧道和存、算、传协同技术则是让血液畅通无阻的那套循环系统。
作为“超智融合”技术的代表, 曙光8000走的一条高难度的技术路线,实现全类型计算的原生一体化融合,支持FP64到INT8全精度,实现了标量、向量与张量计算的灵活混合调用,可覆盖科学计算、大模型训练、AI推理、工业仿真等多种类型业务场景;同时,曙光8000还从斗拱结构汲取灵感,将多达 9 层精密部件装配进不足 9 厘米的极致狭小空间内,实现 0.05 毫米的装配精度;更加关键的是,曙光8000通过全链路系统优化保障大规模集群可靠运行。
事实上,在全类型的复杂计算需求下,曙光8000的存算高效协同能力展现的淋漓尽致。
例如,GPU直通存储技术(XDS)减少CPU中断,充分利用GPU多通道并行能力,让存储到计算的数据传输性能大幅提升;而针对AI训练中最棘手的海量小文件读写,BurstBuffer技术则让海量小文件读性能提升10倍以上;本地内存加速层依赖MEM-Based技术实现纳秒级别的本地读取体验;更加关键的是,存储节点高速层与RDMA网络紧密配合,实现整个系统存储网络带宽提升了2倍,传输延迟降低了3倍。
伟大的超级工程,终究要在业务场景中找到价值落脚点。作为智能时代的数字底座,曙光8000没有只停留在“参数有多猛”,而是让存、算、网真正高效协同起来,在各种真实业务场景的任务里见真章。
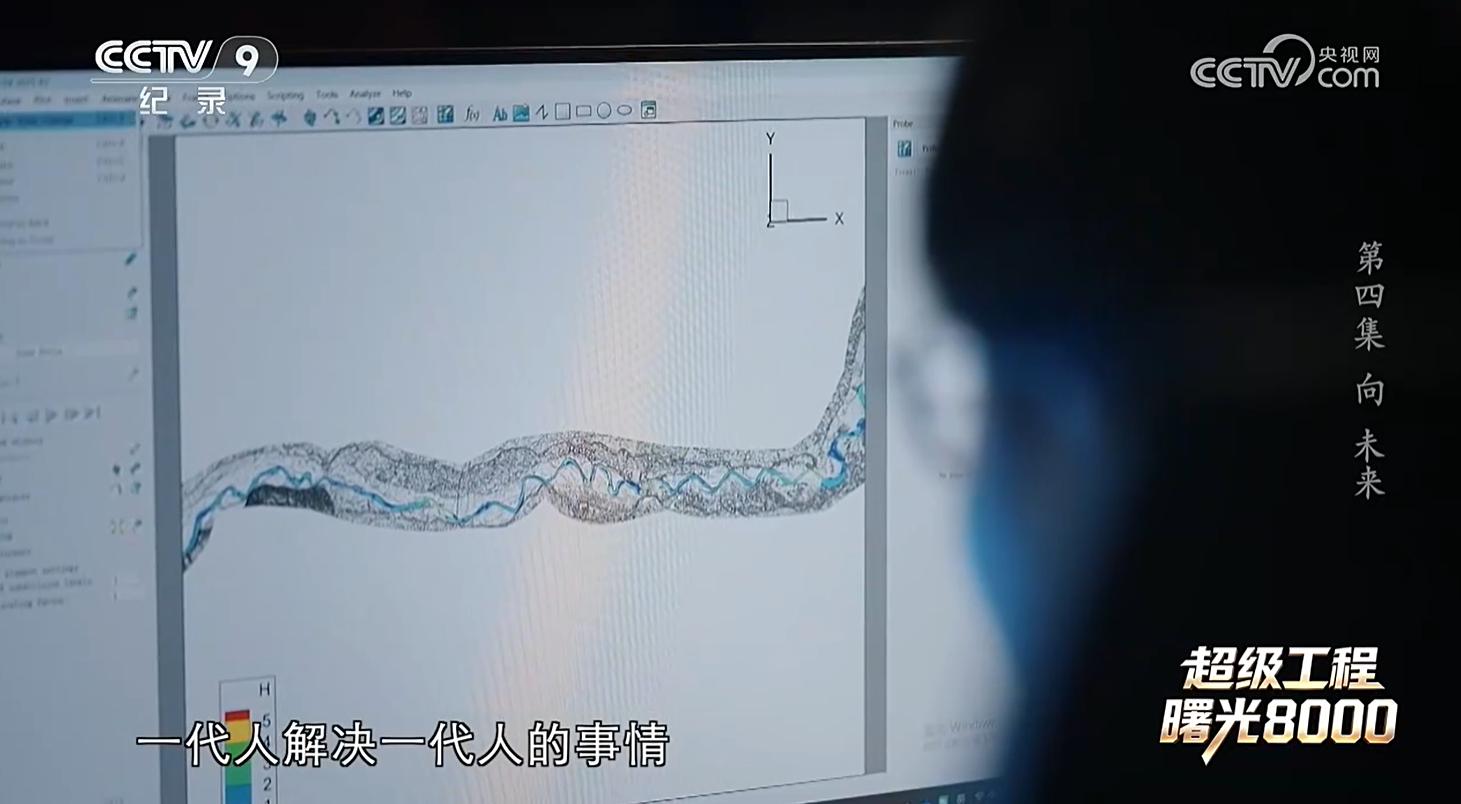
例如,中国气象局地球系统数值预报中心依托曙光8000,实现1小时完成全球5公里分辨率、未来10天的预报计算,达到国际主流业务时效标准;在黄河“数字孪生”科研中,曙光8000开创性实现“智算筛选、超算验证”的协同工作,先用智算算力对河道变量进行智能推演,快速筛选出最可能的河道地形,再通过超算算力对这些方案进行高精度数值模拟推演。
此外,数字孪生脑、玉米基因筛选、大模型训练与推理等应用场景中,曙光8000均展现出强大的能力。
写在最后
中国经济近年来的跨越式发展,从来都不是靠单一要素的突破,而是各行各业中系统能力的建立。
从架桥铺路征服山海,到算力筑底决胜未来。《超级工程》镜头转变释放出清晰的信号:以算力为代表的新型基础设施,正成为支撑一家公司、一个行业乃至一个国家在智能时代发展的重要底座。
曙光8000的意义,不仅仅在于拥有多少张算力卡,而是证明了新型基础设施中系统级能力的重要性,以及全栈技术自研的产业价值。当十万张算力卡满负荷运算、海量数据在一条条“超级隧道”中高效有序传输,曙光8000未来也必然在金融、电信、能源、科研等更广阔的国民经济支柱产业释放出更多价值。